Generar es fácil; responder, no
Un agente puede producir en diez minutos un cambio que a una persona le llevaría una tarde. Esa parte ya no está en discusión. Lo que no cambió es lo demás: alguien tiene que entender ese cambio, decidir si está bien, probarlo y responder por él cuando falle en producción a las once de la noche.
Los equipos que sacan provecho real no son los que generan más código, sino los que ajustaron el flujo para que revisar siga siendo posible. Es un problema de proceso, no de herramienta.
Qué delegar y qué no
| Delega sin culpa | Delega con supervisión | No delegues |
|---|---|---|
| Pruebas para código existente | Funcionalidad nueva acotada | Diseño de la arquitectura |
| Migraciones mecánicas repetidas | Corrección de errores con causa conocida | Modelo de datos |
| Documentación a partir del código | Refactors que cruzan módulos | Decisiones de seguridad |
| Scripts de uso puntual | Integraciones con terceros | Lo que toca dinero o datos personales |
| Conversión de formatos | Optimización de consultas | Lo que nadie del equipo entiende |
La última celda de la derecha merece subrayarse: no delegues código en un área que nadie del equipo domina. No porque el agente vaya a hacerlo mal necesariamente, sino porque nadie podrá juzgar si lo hizo bien. Ahí es donde se acumula la deuda que no se ve hasta que explota.
La regla del PR pequeño, ahora en serio
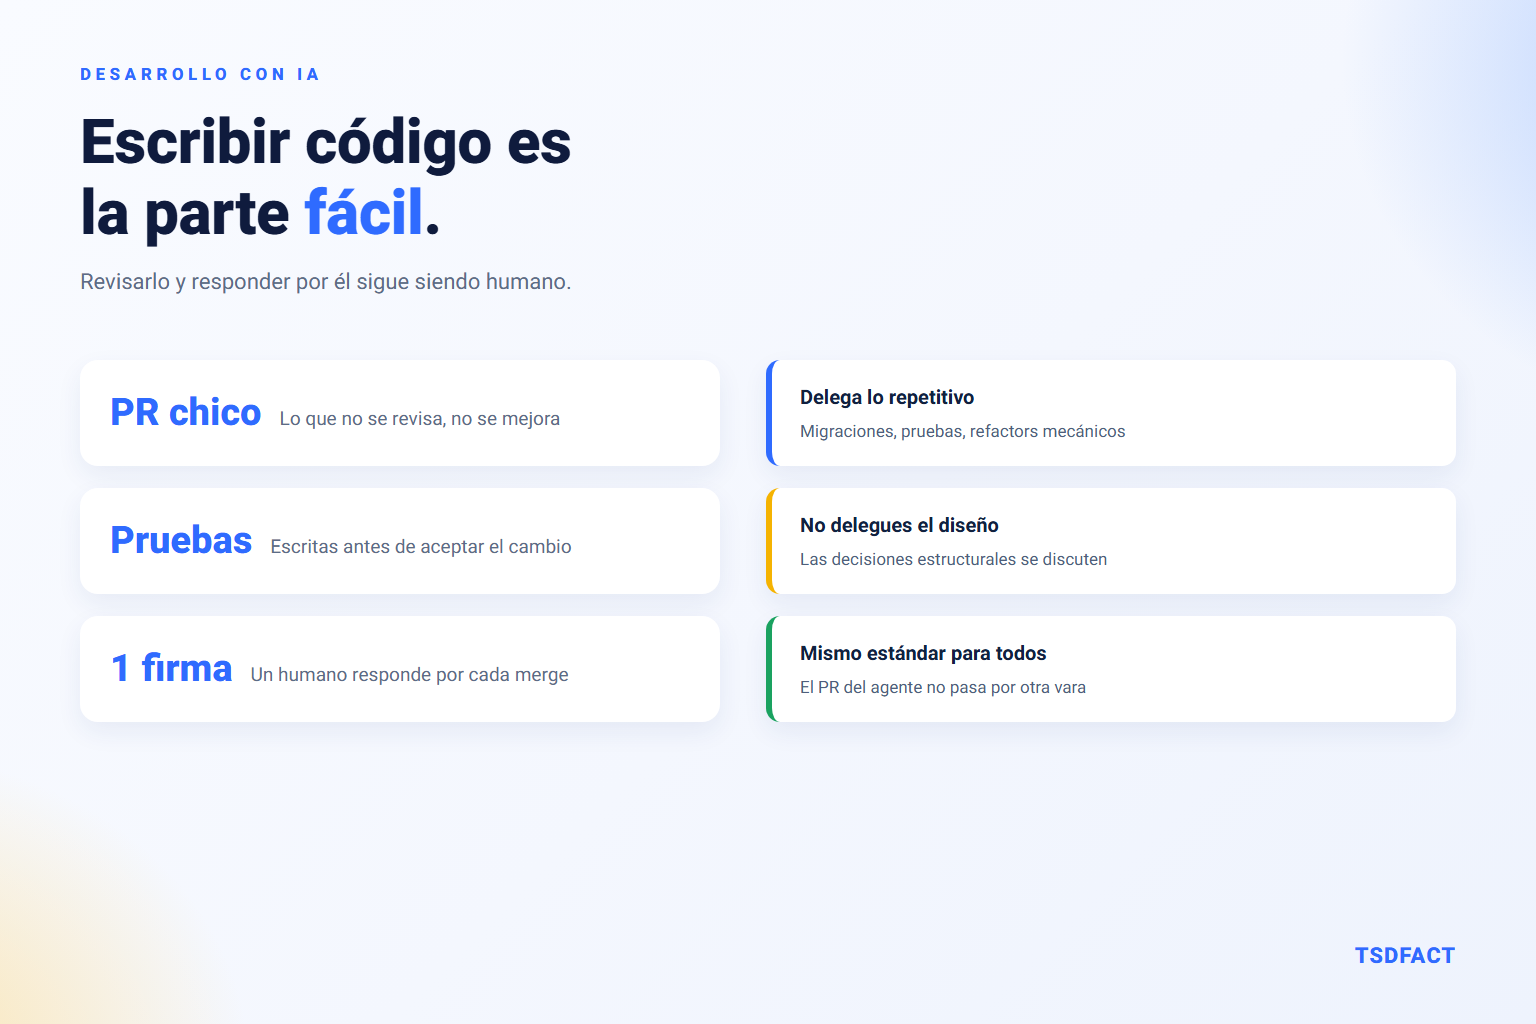
Siempre se supo que los pull requests pequeños se revisan mejor. Con un agente la regla pasa de buena práctica a condición de funcionamiento, porque la restricción dejó de estar en producir y pasó a estar en revisar.
Un PR de 1.500 líneas generado en veinte minutos tiene un destino previsible: se aprueba sin leer. Y un PR aprobado sin leer es código sin dueño, que es exactamente lo que un equipo no quiere acumular.
Lo que funciona en la práctica:
- Un propósito por PR. Si el resumen necesita la palabra «y» dos veces, son dos PR.
- Límite declarado. Muchos equipos fijan un techo —300 o 400 líneas— y lo tratan como regla, no como sugerencia.
- El agente explica el porqué, no el qué. El qué ya está en el diff. Lo que el revisor necesita es qué alternativas se descartaron y qué supuestos se hicieron.
- Separar lo mecánico de lo sustantivo. Un renombrado masivo en su propio PR, para que no esconda el cambio de lógica.
Lo que hay que exigir antes del merge
- Las pruebas pasan, y hay pruebas nuevas. Un cambio de comportamiento sin prueba que lo cubra no entra, lo haya escrito quien lo haya escrito.
- Alguien ejecutó el código. No «se ve bien»: se ejecutó. Los fallos más caros son los que se leen perfectos.
- Las dependencias nuevas se justifican. Los agentes agregan bibliotecas con facilidad. Cada una es superficie de ataque y mantenimiento futuro.
- Un humano firma. Con nombre. No porque haga falta un culpable, sino porque alguien tiene que haberlo entendido.
El punto 4 es el que sostiene todo lo demás. Si nadie entendió el cambio antes de integrarlo, el equipo ya no es dueño de su sistema.
Dónde se acumula la deuda
La deuda técnica que genera este flujo no se parece a la clásica. No es código feo que todos reconocen como feo: es código correcto, bien formateado y con buenos nombres, que sin embargo no encaja con el resto porque se escribió sin ver el conjunto.
Tres síntomas que conviene vigilar:
- Funciones duplicadas con nombres distintos. Nadie buscó si ya existía.
- Cinco formas de hacer lo mismo conviviendo en el mismo proyecto.
- Abstracciones de un solo uso. Capas construidas por si acaso, que solo añaden saltos al leer.
El antídoto es barato y poco glamuroso: convenciones escritas en el repositorio —cómo se nombran las cosas, dónde va cada tipo de archivo, qué bibliotecas ya están elegidas— y pasárselas al agente como parte del contexto de cada tarea. Un agente que conoce las convenciones del proyecto produce código que encaja; uno que no, produce islas.
La revisión también cambia
Revisar código generado requiere mirar en otro orden. Un humano con prisa comete errores de descuido —olvida un caso, se equivoca en un índice—. Un agente comete errores de contexto: resuelve bien lo que entendió, habiendo entendido mal el problema.
Por eso la revisión empieza por arriba:
- ¿Resuelve el problema correcto? Antes que cualquier detalle de implementación.
- ¿Encaja con lo que ya existe? ¿O reimplementó algo que ya estaba?
- ¿Qué casos límite supuso? Suelen estar implícitos en el código, no declarados.
- Y al final, el detalle. Que es justo donde los agentes suelen ser mejores que nosotros.
Conclusión
El flujo que funciona no es «el agente escribe y nosotros aprobamos». Es un equipo que decide qué delegar, mantiene los cambios lo bastante pequeños para revisarlos de verdad, exige pruebas con el mismo rigor de siempre y conserva la propiedad del diseño.
Visto así, la IA no reemplaza criterio: lo hace más necesario, porque ahora hay más código que juzgar por unidad de tiempo. Si quieres el detalle de cómo trabaja un agente de programación por dentro, está en Claude Code y la programación agéntica, y la parte de automatizar pruebas y despliegue, en DevOps y CI/CD para PYMES.