El prompt perfecto ya no es el problema
Entre 2023 y 2024, media industria se dedicó a redactar prompts. "Actúa como un experto en...", "piensa paso a paso", trucos de formato. Funcionaba porque las conversaciones eran cortas y el modelo veía poco.
En 2026 el escenario es otro. Los agentes hacen decenas de llamadas a herramientas, leen documentos, consultan bases de datos y mantienen conversaciones de horas. El prompt inicial es una fracción minúscula de lo que el modelo ve. Lo que decide la calidad de la respuesta es todo lo demás: qué documentos se recuperaron, qué herramientas están declaradas, cuánto historial sobrevive, qué datos entraron y ya no salen.
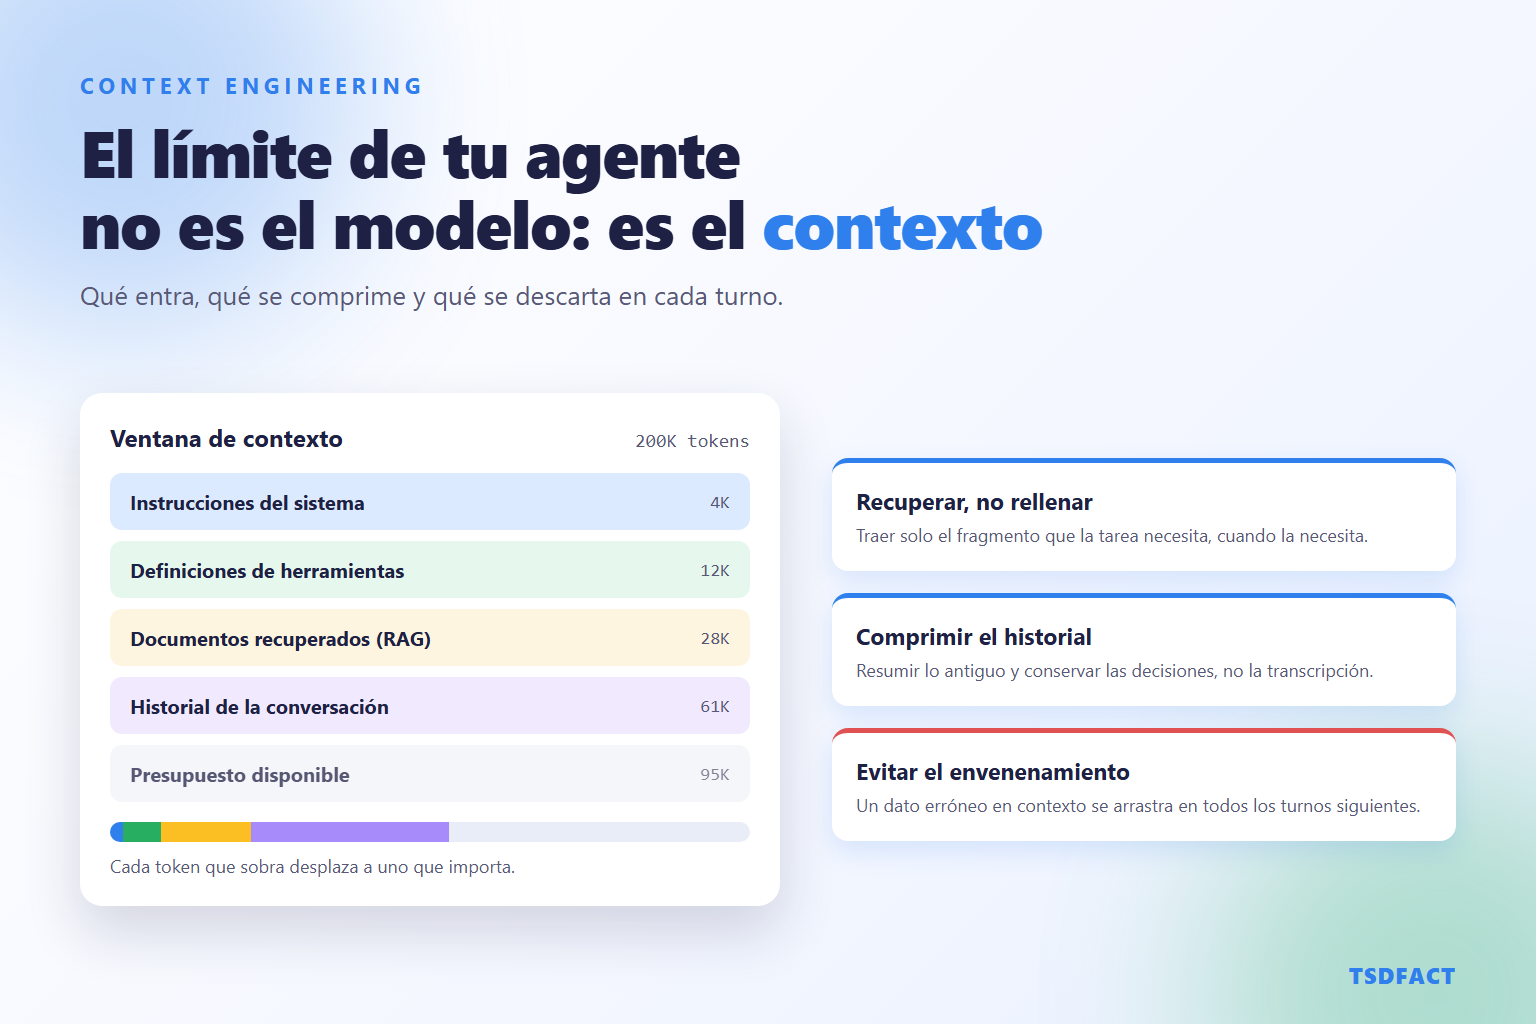
A esa práctica se le llama context engineering: decidir, en cada turno, exactamente qué información merece ocupar un lugar en la ventana de contexto del modelo. Es ingeniería de sistemas, no redacción.
La ventana de contexto es un presupuesto, no un almacén
El error mental más común es tratar la ventana de contexto como espacio de almacenamiento: "tiene 200 mil tokens, metamos todo". No funciona así. Cada token que ocupa lugar desplaza a otro que podría haber sido más útil, y el rendimiento del modelo se degrada mucho antes de llegar al límite duro.
Un reparto típico en un agente de soporte en producción se ve así:
| Componente | Peso típico | Riesgo si crece sin control |
|---|---|---|
| Instrucciones del sistema | 2 - 5K tokens | Reglas contradictorias que el modelo prioriza mal |
| Definiciones de herramientas | 5 - 20K tokens | Con 40 herramientas declaradas, el modelo elige la incorrecta |
| Documentos recuperados (RAG) | 10 - 40K tokens | Fragmentos irrelevantes que compiten con los correctos |
| Historial de la conversación | Crece sin techo | Es el que revienta el presupuesto en sesiones largas |
| Resultados de herramientas | Muy variable | Un SELECT * puede consumir la mitad de la ventana |
Las cuatro formas en que se rompe el contexto
1. Envenenamiento (context poisoning). Un dato incorrecto entra al contexto —una alucinación previa, un documento desactualizado, un resultado mal parseado— y a partir de ahí el modelo lo trata como verdad en todos los turnos siguientes. Es el fallo más difícil de diagnosticar porque el agente responde con total seguridad.
2. Saturación (context overload). Le pasas 40 mil tokens de documentación esperando que "encuentre lo relevante". El modelo se distrae: la señal se diluye en el ruido. Menos contexto bien elegido rinde más que mucho contexto genérico.
3. Desborde del historial. La conversación crece, se llega al límite y algo se corta. Si el corte es ciego —eliminar los mensajes más viejos— puedes estar borrando justo la instrucción que definía toda la tarea.
4. Confusión de herramientas. Cuando hay demasiadas herramientas declaradas con descripciones parecidas, el agente llama a la equivocada. No es un problema del modelo: es un problema de diseño del catálogo de herramientas.
Los cuatro patrones que sí funcionan
1. Recuperación bajo demanda, no precarga
No metas el manual completo en el contexto. Deja que el agente pida el fragmento que necesita cuando lo necesita. Si tu manual tiene 300 páginas, el agente debería ver 2, no 300. Esto conecta directo con RAG: lo desarrollamos en IA + RAG: qué es y cómo aplicarlo en tu empresa.
2. Divulgación progresiva de herramientas
En lugar de declarar 40 herramientas desde el inicio, expón un grupo pequeño y deja que el agente descubra las demás según la fase de la tarea. Menos opciones simultáneas, menos errores de selección.
3. Compresión del historial
Cuando la conversación se alarga, resume lo antiguo conservando decisiones y hechos, no la transcripción literal. "El cliente es Comercial Andina, RUC 20xxxxxxx, pidió cotización de 40 laptops, presupuesto S/ 120,000" ocupa 30 tokens y reemplaza 3,000 de conversación.
4. Estructura navegable
Los documentos con encabezados claros funcionan mejor que los bloques de texto corrido. El agente localiza la sección relevante en lugar de leer todo. Si tu base de conocimiento son PDFs escaneados sin estructura, ese es tu primer problema, no el modelo.
Caso práctico: un asistente de cotizaciones que empeoraba con el uso
La situación. Una distribuidora implementó un asistente para armar cotizaciones. Funcionaba bien las primeras consultas y se volvía errático después de 20 o 30 minutos de conversación: confundía precios, mezclaba clientes, repetía productos ya descartados.
El diagnóstico. No era el modelo. Eran tres cosas:
- Cada consulta a la base de datos devolvía la tabla de precios completa (1,800 productos) al contexto.
- El historial nunca se comprimía: a los 30 minutos ocupaba el 70% de la ventana.
- Cuando un producto se descartaba, el descarte quedaba en el historial pero el producto también, y el modelo volvía a proponerlo.
Los cambios.
ANTES                              DESPUÉS
─────────────────────────────      ─────────────────────────────
buscar_precios()                   buscar_precios(filtro, limite=10)
→ 1,800 filas al contexto          → 10 filas relevantes

historial completo                 resumen cada 15 turnos
→ 70% de la ventana                → 8% de la ventana

descartes en el historial          estado explícito de la cotización
→ el modelo los ignoraba           → {incluidos:[], descartados:[]}

12 herramientas declaradas         4 al inicio + resto por fase
→ llamadas incorrectas             → selección correcta
El resultado. El consumo de tokens por cotización bajó cerca de un 60%, el costo mensual de API cayó en la misma proporción y —lo más importante— las cotizaciones dejaron de tener errores de precio. No se cambió de modelo ni se reescribió el prompt: se rediseñó qué información veía el agente y cuándo.
Cómo auditar el contexto de tu agente
Si ya tienes un agente en producción y su calidad es irregular, revisa esto en orden:
- Registra el contexto completo de las conversaciones que fallaron. No el prompt: todo lo que el modelo vio en ese turno.
- Mide la distribución. ¿Qué porcentaje es historial? ¿Cuánto son resultados de herramientas? ¿Cuánto es realmente relevante para la pregunta?
- Busca datos falsos persistentes. Si el mismo error se repite en toda la conversación, tienes envenenamiento.
- Revisa el catálogo de herramientas. ¿Hay dos con descripciones que un humano confundiría? El modelo también las confunde.
- Pon un tope explícito a lo que cada herramienta puede devolver. Ninguna consulta debería poder inyectar 20 mil tokens.
- Define la política de compresión: cada cuántos turnos, qué se conserva y qué se descarta.
Qué medir
| Métrica | Qué te dice | Señal de alarma |
|---|---|---|
| Tokens de entrada por interacción | Cuánto estás pagando por turno | Crece linealmente con la duración de la sesión |
| Proporción de contexto útil | Qué parte de lo enviado se usó realmente | Menos del 30% |
| Tasa de herramienta correcta | Si el agente elige bien | Bajo 90% con catálogo grande |
| Degradación por longitud | Calidad al inicio vs. a los 30 minutos | Cualquier caída notoria |
| Costo por conversación resuelta | La métrica de negocio real | Sube mientras el volumen sube |
Conclusión
Cambiar de modelo es la solución que primero se intenta y casi nunca es la que hace falta. Antes de pagar por un modelo más grande, revisa qué le estás mostrando al que ya tienes: en la mayoría de agentes que auditamos, la mitad del contexto era ruido y una parte del ruido era información falsa que el agente arrastraba desde el turno tres.
El context engineering no es glamoroso —es presupuestar, recortar, resumir y ordenar— pero es lo que separa una demo que impresiona de un sistema que aguanta seis meses en producción.