Ya hay un procesador delante del usuario
El reflejo por defecto al diseñar una aplicación web es: el usuario sube algo, el servidor lo procesa, el usuario descarga el resultado. Es un patrón conocido y funciona. Pero implica pagar cómputo, almacenamiento y ancho de banda por una tarea que el equipo del usuario —un teléfono moderno tiene ocho núcleos— podría hacer solo.
Qué permite hoy un navegador
| Tecnología | Para qué sirve | Ejemplo |
|---|---|---|
| Canvas API | Manipular imágenes píxel a píxel | Recortar, redimensionar, filtros, marca de agua |
| Web Workers | Ejecutar en segundo plano sin congelar la interfaz | Procesar 50 imágenes sin que la página se trabe |
| WebAssembly | Correr código compilado a velocidad casi nativa | Códecs, compresión, PDF, criptografía |
| File System Access | Leer y escribir archivos con permiso del usuario | Editar una carpeta completa sin subirla |
| IndexedDB | Almacenar datos estructurados en el equipo | Trabajo en curso que sobrevive a recargar |
| WebCodecs | Codificar y decodificar audio y video | Recortar un video sin subirlo |
Los tres beneficios reales
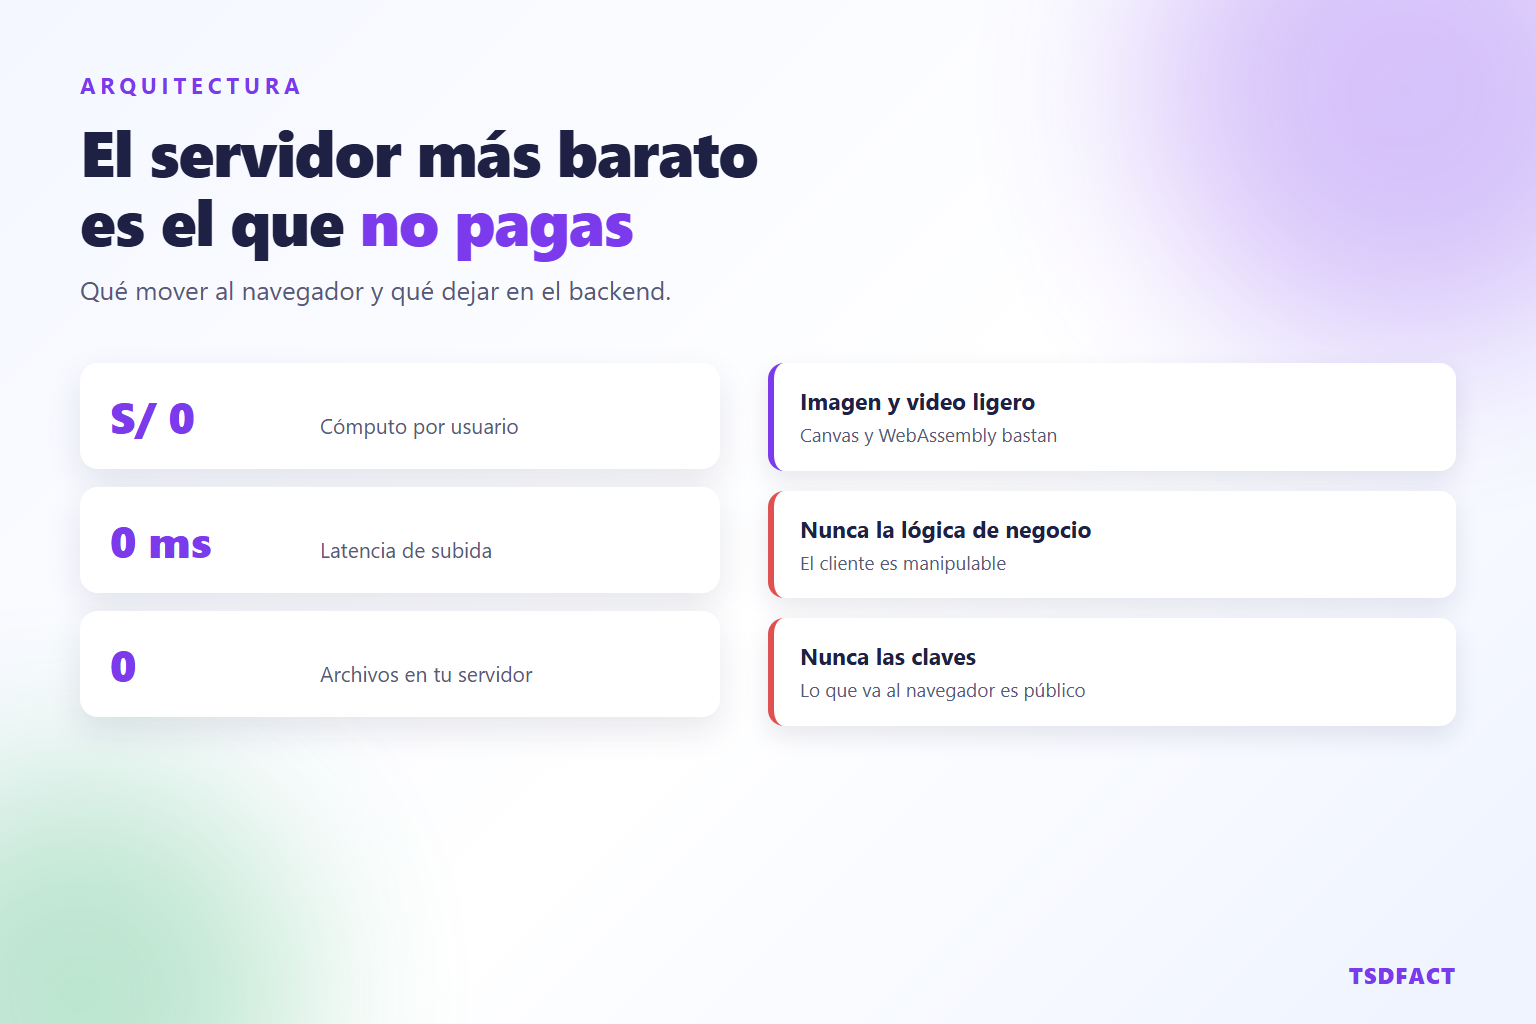
1. El costo de cómputo desaparece. No es que baje: no existe. Diez usuarios o diez mil consumen exactamente los mismos recursos de tu servidor, porque el servidor solo entrega archivos estáticos. Una aplicación de este tipo se aloja en un CDN por unos pocos soles al mes con independencia del tráfico.
2. Se elimina la latencia de subida y bajada. Procesar una imagen de 8 MB en servidor implica subirla y descargar el resultado; con una conexión móvil peruana promedio eso puede ser medio minuto. En local, el archivo ya está donde tiene que estar.
3. La privacidad deja de ser una promesa. No es "no guardamos tus archivos": es que no hay forma de guardarlos porque nunca llegan. Es un argumento verificable por cualquiera abriendo la pestaña de red, como explicamos en qué pasa con los archivos que subes a herramientas online.
Dónde está el límite
Esta es la parte que se omite en los artículos entusiastas. Hay cosas que no deben moverse al cliente nunca:
- La lógica de negocio que decide algo. Precios, descuentos, permisos, validaciones de seguridad. Todo lo que llega al navegador es inspeccionable y modificable por el usuario. Valida siempre en el servidor.
- Claves y credenciales. Una clave de API en el código del cliente es una clave pública, por mucho que esté ofuscada.
- Datos que otros usuarios deben ver. Si hay que compartir, hay que persistir en algún sitio.
- Modelos de IA grandes. Un modelo de varios gigabytes no se descarga en cada visita.
- Trabajos muy largos. Si tarda cinco minutos, el usuario cierra la pestaña y pierde todo.
Y hay limitaciones prácticas que conviene medir antes de comprometerse: la memoria disponible en un móvil de gama baja es mucho menor de lo que sugiere tu laptop de desarrollo, y el rendimiento entre un iPhone reciente y un Android económico puede diferir en un orden de magnitud.
Cómo decidir
| Pregunta | Si la respuesta es sí |
|---|---|
| ¿El resultado solo le interesa a quien lo genera? | Candidato claro para el cliente |
| ¿El archivo es sensible? | Fuerte argumento para el cliente |
| ¿La tarea termina en menos de 30 segundos? | Viable en el cliente |
| ¿Se necesita guardar o compartir el resultado? | Necesitas servidor |
| ¿Hay dinero, permisos o decisiones de por medio? | Obligatoriamente servidor |
| ¿Requiere una librería enorme? | Evalúa el peso de la primera carga |
El patrón híbrido, que suele ser la respuesta
Casi nunca es todo o nada. El reparto que mejor funciona en la práctica:
NAVEGADOR                          SERVIDOR
─────────────────────────          ─────────────────────────
Vista previa inmediata             Autenticación
Recorte y redimensionado           Reglas de negocio y precios
Compresión y conversión            Persistencia y compartición
Validación de formato              Validación real
Trabajo en curso (IndexedDB)       Tareas largas o pesadas
                                   Integraciones con terceros
El usuario percibe una aplicación instantánea porque todo lo interactivo ocurre en su equipo; el servidor solo interviene cuando de verdad hace falta.
Un caso propio
Al construir ChasquImage tomamos deliberadamente la ruta del cliente: conversión, compresión, redimensionado, recorte, filtros y marca de agua ocurren en el navegador con Canvas y Web Workers. El servidor entrega HTML, CSS y JavaScript, y nada más.
Las consecuencias fueron las esperadas y algunas no tanto. El costo de infraestructura es el de un sitio estático, sin importar cuánta gente lo use. No hay cola de trabajos, ni almacenamiento temporal, ni política de retención que redactar, ni superficie de ataque sobre archivos ajenos. A cambio, hubo que trabajar bastante el rendimiento en móviles modestos y aceptar que los lotes muy grandes dependen de la memoria del equipo del visitante.
Para el caso contrario —ChasquiPDF— el OCR y algunas conversiones sí requieren servidor, y ahí la decisión honesta fue procesar en infraestructura propia con borrado automático a las 6 horas, en lugar de fingir que todo era local.
Conclusión
El navegador dejó hace tiempo de ser solo una capa de presentación. Para tareas acotadas sobre archivos del propio usuario, mover el cómputo al cliente elimina costos, elimina latencia y convierte la privacidad en una propiedad de la arquitectura en lugar de una promesa comercial. Lo que no elimina es la necesidad de un servidor para todo lo que involucre confianza: ahí el cliente no puede ser la autoridad, nunca.