La pregunta cambia
En el piloto la pregunta es «¿puede hacerlo?». Se arma un caso, se prueba con datos de ejemplo, funciona, y todos salen convencidos de la reunión.
En producción la pregunta es otra: «¿quién responde cuando se equivoque?». Y la diferencia entre ambas preguntas es, en la práctica, la mitad del proyecto.
Lo que el piloto no probó
Un piloto demuestra capacidad. No demuestra ninguna de estas siete cosas, que son justamente las que deciden si el agente sobrevive al tercer mes:
- Qué hace con una entrada rara. Un PDF escaneado al revés, un cliente que escribe en tres idiomas, un campo vacío que nunca estaba vacío.
- Qué pasa cuando la herramienta falla. El ERP se cayó: ¿reintenta, avisa, inventa un número?
- Cuánto cuesta a volumen real. Cuarenta casos de prueba no anticipan cuatro mil al mes.
- Qué tan rápido es cuando hay cola.
- Quién lo revisa.
- Cómo se apaga.
- Qué se hace con lo que ya hizo mal.
Los cinco requisitos mínimos
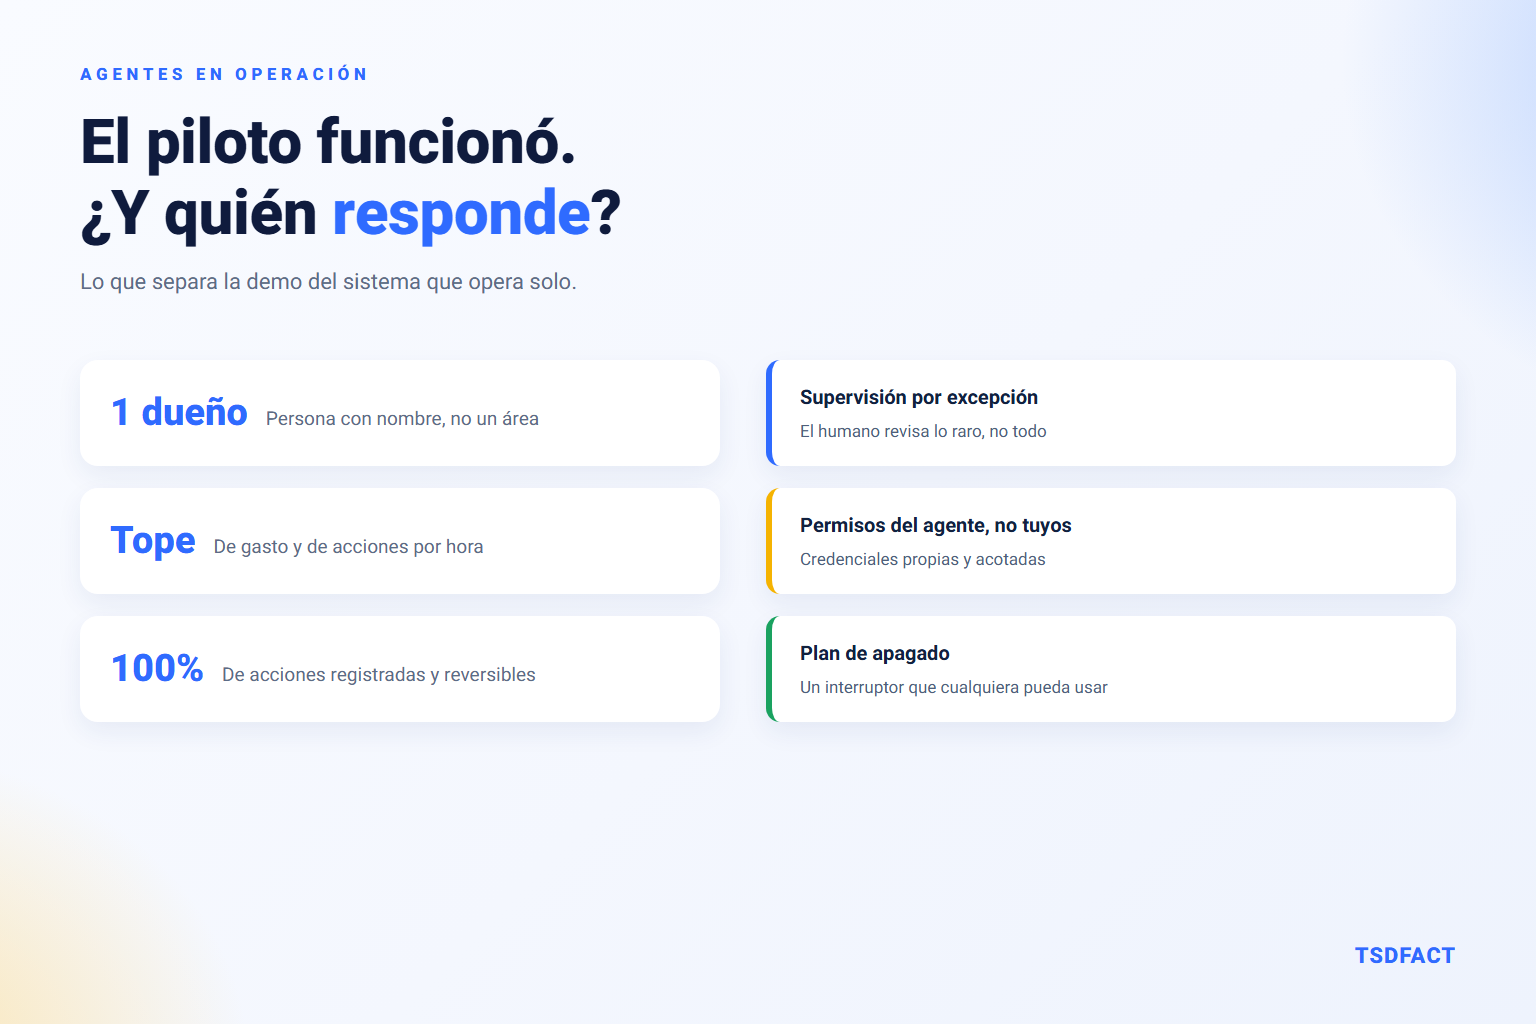
1. Un dueño con nombre propio. No «el área de operaciones». Una persona que recibe las alertas, que decide si se apaga y que revisa el tablero cada semana. Un agente sin dueño se degrada en silencio: nadie nota que desde la actualización del catálogo responde peor, porque nadie está mirando.
2. Credenciales propias y acotadas. El agente no usa el usuario de nadie. Tiene el suyo, con el conjunto exacto de permisos que su tarea necesita. Esto no es burocracia: es lo que determina el tamaño del daño el día que algo salga mal, sea por un error del modelo o por una inyección de prompts.
3. Límites duros. Techo de gasto por día, máximo de acciones por hora, monto máximo por operación. Los límites hacen dos cosas: contienen el daño de un bucle y convierten un incidente silencioso en una alerta. Un agente que se queda sin presupuesto a las diez de la mañana avisa de un problema; uno sin tope lo descubre la tesorería a fin de mes.
4. Trazas de todo. Cada acción registrada con qué información vio, qué decidió, qué herramienta llamó y con qué resultado. Sin esto es imposible responderle a un cliente que reclama por algo que pasó hace tres días.
5. Un interruptor que cualquiera pueda usar. Apagar el agente no debe requerir un despliegue ni al desarrollador que está de vacaciones. Un conmutador en una pantalla de administración, y el sistema sigue funcionando sin el agente —degradado, con más trabajo manual, pero funcionando.
Supervisión: del «en el circuito» al «sobre el circuito»
El patrón que más se ha consolidado en 2026 es el paso de pedir aprobación humana en cada paso a supervisar por excepción. La diferencia:
| Humano en el circuito | Humano sobre el circuito | |
|---|---|---|
| Aprobación | Cada acción | Solo las excepciones |
| Velocidad | La del revisor | La del agente |
| Riesgo | Mínimo | Acotado por los límites |
| Problema típico | El revisor empieza a aprobar sin leer | Las excepciones mal definidas no se detectan |
| Cuándo usarlo | Dinero, datos personales, lo irreversible | Clasificar, redactar borradores, consultar |
El riesgo real del primer modelo es que se degrada solo: cuando una persona tiene que aprobar doscientas acciones al día, a la semana aprueba sin leer, y la supervisión se vuelve un trámite que da falsa tranquilidad. Conviene reservarlo para lo que de verdad lo amerita.
Define la excepción antes de arrancar
Si el agente va a escalar solo lo raro, hay que decir por escrito qué es «raro». Una definición utilizable tiene tres partes:
- Umbrales: monto por encima de X, antigüedad mayor a Y, más de Z intentos.
- Categorías: reclamos, temas legales, clientes marcados, cualquier cosa que mencione un reembolso.
- Señales del propio agente: baja confianza, información contradictoria entre fuentes, herramienta que falló dos veces.
Y un principio por defecto: ante la duda, escala. Un agente que escala de más genera trabajo; uno que escala de menos genera incidentes.
Qué mirar la primera semana
Cinco números en un tablero, revisados a diario los primeros quince días:
- Volumen procesado frente a lo esperado. Una caída brusca suele ser una integración rota, no menos demanda.
- Tasa de escalada. Muy alta: el alcance estaba mal definido. Muy baja: quizá no está escalando lo que debería.
- Costo por caso resuelto. El número que vuelve concreta la conversación con gerencia.
- Errores de herramienta. Casi siempre son el origen real de las respuestas extrañas.
- Latencia p95. El promedio miente; el percentil 95 es lo que sienten los usuarios que abandonan.
Conclusión
Llevar un agente a producción se parece menos a terminar un modelo y más a incorporar a alguien nuevo: hay que darle accesos acotados, explicarle qué no debe decidir solo, dejar claro a quién recurre cuando duda y revisar su trabajo al principio con más frecuencia que después.
Visto así, la lista deja de parecer burocracia. Un piloto que no pasa por ese proceso no se convierte en producción: se convierte en una demo que alguien dejó encendida. Para la parte de medir si realmente está funcionando, el método está en cómo evaluar si tu IA funciona.