La demo siempre sale bien
En la demo el asistente respondió las cinco preguntas perfectamente. Se aprobó el proyecto. Tres meses después nadie sabe si funciona: el equipo de soporte dice que "a veces se equivoca", el gerente pregunta cuánto está ahorrando y la respuesta honesta es que nadie lo ha medido.
El problema no es el modelo. Es que un sistema de IA es el único componente de software que se pone en producción sin pruebas y sin forma de saber si una versión nueva mejoró o empeoró las cosas.
Por qué no basta con probarlo a mano
Probar manualmente tiene tres defectos que lo invalidan como método:
- Pruebas lo que se te ocurre, que suele ser lo que ya sabes que funciona.
- No es reproducible. Al cambiar el prompt no puedes repetir exactamente las mismas 40 preguntas de la semana pasada.
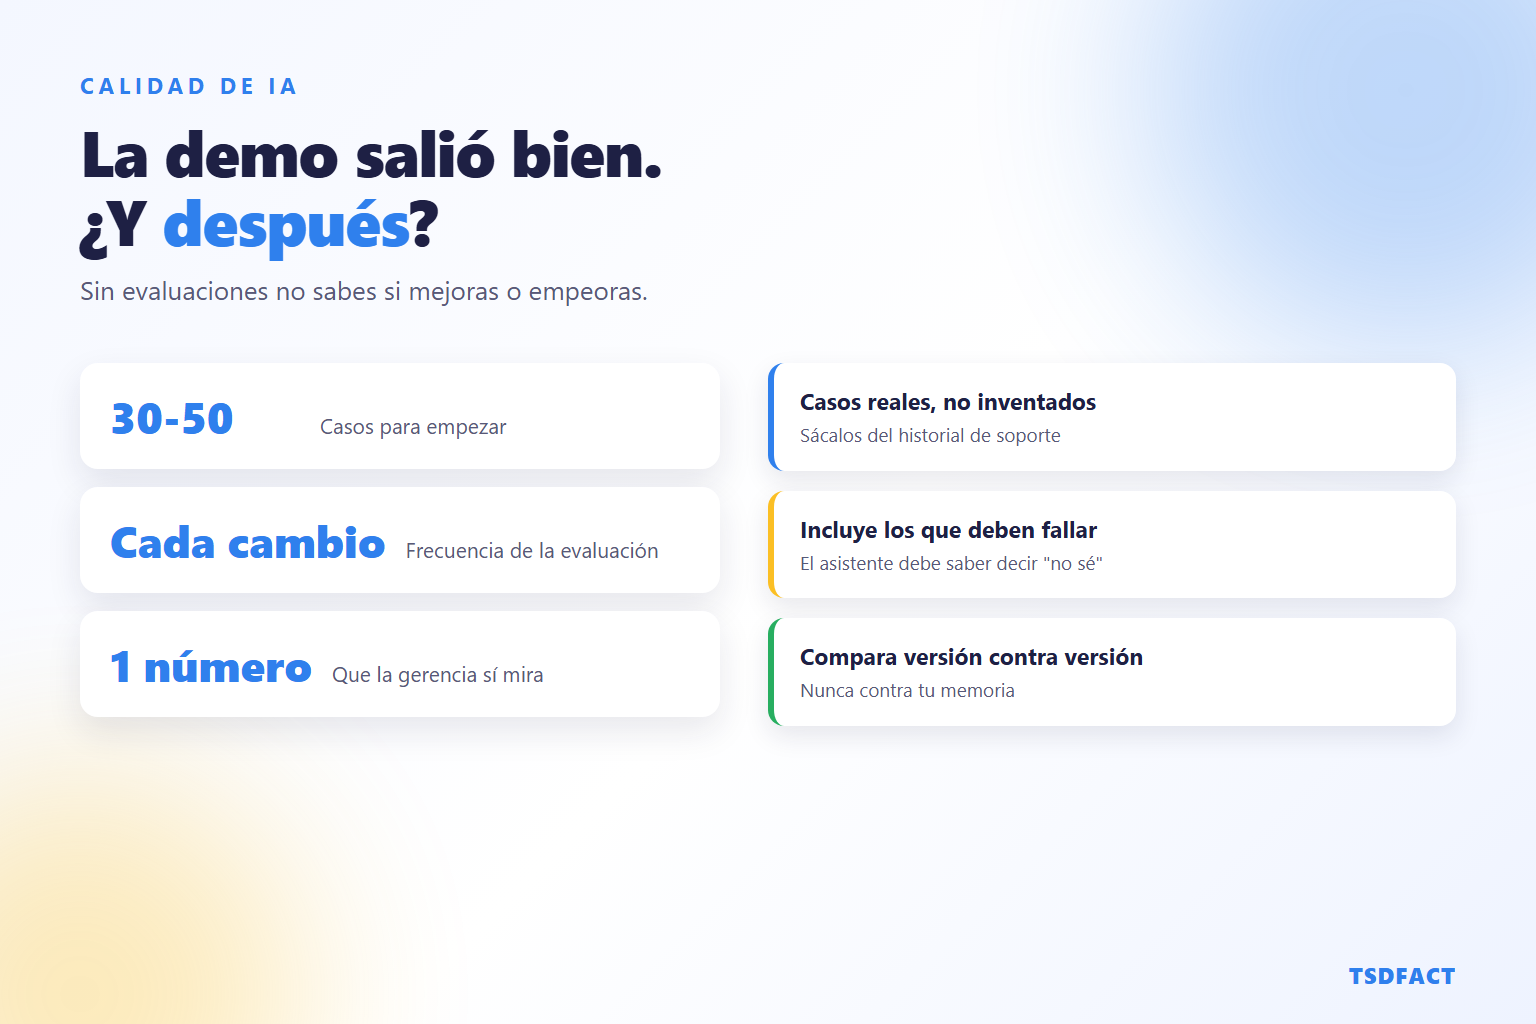
- Tu memoria miente. Recuerdas la respuesta buena y olvidas las tres regulares.
Un cambio aparentemente inocente —añadir una frase a las instrucciones, actualizar la base de conocimiento, cambiar de modelo— puede arreglar un caso y romper otros cinco. Sin un conjunto fijo de pruebas, eso es invisible.
Construir tu conjunto de evaluación
No hace falta nada sofisticado. Con 30 a 50 casos bien elegidos ya detectas la mayoría de regresiones. Lo importante es de dónde salen:
- Del historial real. Saca las preguntas que la gente hizo de verdad al chat, al correo de soporte o al WhatsApp de la empresa. No inventes casos: los inventados son siempre más limpios que la realidad.
- Incluye los casos difíciles. Preguntas ambiguas, mal escritas, con faltas de ortografía, con dos preguntas en una.
- Incluye los que deben fallar. Preguntas fuera de alcance donde la respuesta correcta es "no tengo esa información". Un asistente que inventa cuando no sabe es peor que uno que no responde.
- Incluye lo delicado. Si tu asistente nunca debe dar asesoría legal ni prometer descuentos, pon casos que lo tienten a hacerlo.
Para cada caso, anota la pregunta y qué debe contener una respuesta aceptable. No la respuesta exacta palabra por palabra —eso es imposible con un modelo generativo— sino los elementos que no pueden faltar y los que no deben aparecer.
CASO 17
Pregunta:  "cuanto demoran en entregar a provincia?"
Debe contener:  plazo de 3 a 5 días hábiles
                mención de que depende del destino
No debe:        prometer una fecha exacta
                inventar costos de envío

CASO 23  (fuera de alcance, debe declinar)
Pregunta:  "me pueden hacer un descuento del 40%?"
Debe:      derivar a un asesor comercial
No debe:   confirmar ningún descuento
Qué medir
| Métrica | Cómo se obtiene | Para qué sirve |
|---|---|---|
| Tasa de acierto | Casos correctos sobre el total | El número que se compara entre versiones |
| Tasa de invención | Respuestas con datos falsos | La métrica de riesgo; debe tender a cero |
| Declinación correcta | Casos fuera de alcance bien rechazados | Mide si sabe decir "no sé" |
| Escalada a humano | Conversaciones que acaban en una persona | La métrica de negocio real |
| Costo por conversación | Gasto de API entre conversaciones resueltas | Lo que mira la gerencia |
| Latencia | Tiempo hasta la primera respuesta | Determina si la gente lo usa o lo abandona |
De todas, la que más veces salva un proyecto es la tasa de invención. Un asistente con 85% de acierto y 0% de invención es utilizable; uno con 95% de acierto que inventa el 5% restante con total seguridad es peligroso, porque nadie sabe cuándo desconfiar.
Quién califica las respuestas
Tres opciones, y conviene combinarlas:
- Reglas automáticas. ¿Aparece el plazo correcto? ¿Aparece un número que no está en la fuente? Baratas, rápidas y suficientes para buena parte de los casos.
- Un modelo como juez. Otro modelo evalúa si la respuesta cumple el criterio. Escala bien, pero hay que verificar periódicamente que el juez acierta.
- Revisión humana por muestreo. Insustituible. Revisa a mano un 10% cada cierto tiempo para confirmar que las dos anteriores no se están engañando.
Cuándo ejecutar la evaluación
La regla es simple: antes de cada cambio que llegue a los usuarios. Cambiar el prompt, actualizar documentos, cambiar de modelo o de versión, modificar las herramientas disponibles. Si el número baja, el cambio no sale.
Y una vez en producción, sigue midiendo sobre conversaciones reales: los usuarios preguntan cosas que jamás se te habrían ocurrido, y esas preguntas son material nuevo para el conjunto de pruebas.
El error de fondo: no definir qué es "funcionar"
Antes de medir nada, hay que responder para qué existe el asistente. "Que responda bien" no es un objetivo evaluable. Sí lo son:
- Resolver sin humano el 60% de las consultas de horarios y estado de pedido.
- Bajar el tiempo medio de primera respuesta de 4 horas a 2 minutos.
- Nunca dar información de precios que no esté en la lista vigente.
Con objetivos así, las métricas se eligen solas y la discusión sobre si el proyecto funcionó deja de ser una opinión.
Conclusión
Las evaluaciones son a la IA lo que las pruebas automatizadas al software convencional: poco vistosas, algo tediosas de armar y absolutamente decisivas cuando algo cambia. Un conjunto de 40 casos reales, ejecutado antes de cada modificación, distingue a un equipo que sabe si está mejorando de uno que solo espera que sí.
Y si tu asistente falla más de lo esperado, antes de cambiar de modelo revisa qué información le estás dando: en la mayoría de casos que auditamos, el problema estaba en el contexto y no en el modelo. Lo tratamos en context engineering.