La factura que nadie presupuestó
La conversación típica empieza así: «el modelo cuesta tres dólares por millón de tokens, procesamos unas mil consultas al mes, esto sale barato». Dos meses después la factura es diez veces la estimación y nadie sabe explicar por qué.
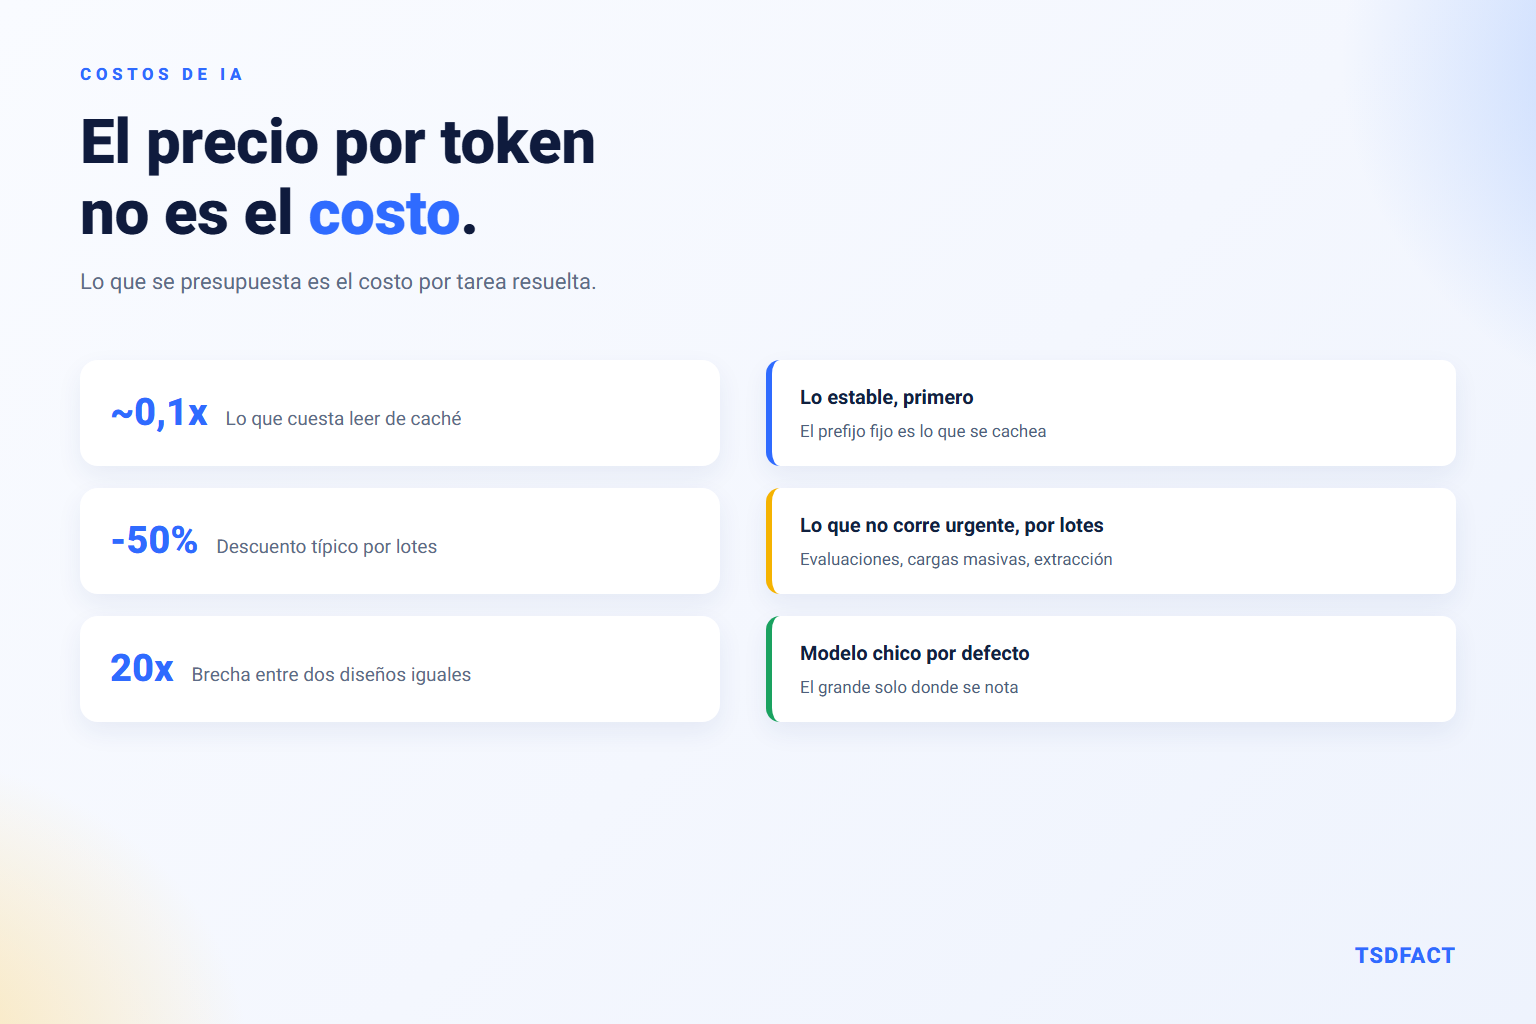
La estimación no estaba mal hecha. Estaba hecha sobre la unidad equivocada. El precio por token no es el costo; el costo es lo que sale resolver una tarea completa, y entre esas dos cosas hay un factor que puede superar el 20x con el mismo modelo.
Por qué una tarea cuesta más de lo que parece
Lo que se paga no es «una consulta». En un sistema con herramientas, una sola petición del usuario desencadena varias llamadas al modelo, y cada una arrastra todo el contexto acumulado:
Usuario: "¿cuándo llega mi pedido 48219?"

Llamada 1   prompt de sistema + esquemas de herramientas + pregunta
            → decide consultar el ERP
Llamada 2   todo lo anterior + resultado del ERP
            → decide consultar al transportista
Llamada 3   todo lo anterior + respuesta del transportista
            → redacta la respuesta

El prompt de sistema y los esquemas se pagan TRES veces.
De ahí salen las sorpresas. El prompt de sistema de 4.000 tokens que parecía inofensivo se multiplica por el número de pasos y por el número de conversaciones. Ese es, casi siempre, el grueso de la factura.
Caché de prompts: la palanca más grande
El caché existe justamente para eso. La idea: si el comienzo del prompt es idéntico entre llamadas, el proveedor lo guarda procesado y lo cobra mucho más barato al reutilizarlo.
| Operación | Costo relativo | Comentario |
|---|---|---|
| Entrada normal | 1x | La referencia |
| Escritura en caché corta | ~1,25x | Se paga una vez al crear |
| Escritura en caché larga | ~2x | Para prefijos muy reutilizados |
| Lectura de caché | ~0,1x | Aquí está el ahorro |
| Lotes (batch) | ~0,5x | A cambio de procesamiento diferido |
Con esos órdenes de magnitud, el punto de equilibrio llega rápido: a partir de la segunda o tercera lectura el caché ya salió a cuenta. Y hay un detalle que decide todo: el caché funciona por prefijo. Si una sola palabra cambia al inicio, no hay coincidencia.
De ahí la única regla de diseño que importa aquí: lo estable primero, lo variable al final. Prompt de sistema, esquemas de herramientas y documentos de referencia arriba; la pregunta del usuario y la fecha de hoy abajo. Poner un «Hoy es 11 de octubre de 2026, 14:32» al comienzo del prompt invalida el caché en cada llamada, y es un error sorprendentemente común.
Las tarifas y los mínimos cambian entre proveedores y entre versiones. Las cifras de la tabla son el orden de magnitud habitual en 2026; antes de presupuestar, conviene mirar la página de precios vigente.
Lotes: la mitad de precio por esperar
Los tres proveedores grandes ofrecen descuentos de alrededor del 50% en entrada y salida para trabajo enviado por su API de lotes, con la condición de aceptar procesamiento asíncrono dentro de una ventana de hasta 24 horas.
Es dinero regalado para todo lo que no necesita respuesta inmediata:
- Ejecutar el conjunto de evaluaciones antes de un cambio.
- Clasificar o etiquetar el histórico.
- Extraer datos de un lote de facturas del mes.
- Generar resúmenes o descripciones en masa.
- Reprocesar lo que falló durante el día.
Y en algunos proveedores los descuentos se combinan: lote más caché sobre la parte repetida deja el costo de esa porción en una fracción mínima del precio de lista.
Enrutar por dificultad
La tercera palanca es la más obvia y la menos aplicada: no todas las tareas necesitan el modelo grande. Clasificar un correo en cinco categorías, decidir si un texto está en español, extraer un número de un campo o decidir qué herramienta llamar son trabajos que un modelo pequeño resuelve igual de bien y por una fracción del precio.
Una política de enrutamiento simple suele bastar:
- Clasificación, extracción y decisiones binarias → modelo pequeño.
- Redacción, razonamiento sobre varios documentos, código → modelo grande.
- Si el modelo pequeño reporta baja confianza, reintentar con el grande.
El escalón 3 es el que hace que la política sea segura: el ahorro se queda y los casos difíciles igual terminan bien atendidos.
Las trampas de la letra chica
- Contexto largo con recargo. Varios proveedores cobran una tarifa mayor cuando el prompt supera cierto umbral, y el recargo aplica a la petición entera. Un sistema que mete «todo por si acaso» puede anular con eso todos los ahorros del caché.
- Tokens de razonamiento. En modelos que razonan antes de responder, ese razonamiento se factura aunque no se muestre.
- Reintentos silenciosos. Una herramienta que falla y se reintenta tres veces cobra tres veces.
- Promociones que vencen. Si el presupuesto del año que viene asume la tarifa promocional de hoy, conviene anotar la fecha de vencimiento ahora.
- Medir peticiones en vez de tokens. El número de peticiones puede quedarse quieto mientras la factura sube, simplemente porque las conversaciones se alargaron.
Qué poner en el tablero
Cuatro métricas y una alerta bastan para no volver a sorprenderse:
- Costo por tarea resuelta, no por llamada ni por token.
- Tasa de aciertos de caché. Si cae de golpe, alguien tocó el prefijo del prompt.
- Tokens por conversación, separando entrada, salida y caché.
- Reparto por modelo, para ver si el enrutamiento está funcionando.
Conclusión
Las tres palancas —ordenar el prompt para que el caché funcione, mandar por lotes lo que no corre prisa y enrutar por dificultad— no requieren cambiar de proveedor ni rediseñar nada. Son decisiones de ingeniería que, aplicadas juntas, suelen dejar la factura en una fracción de la original sin tocar la calidad.
Lo que sí hay que cambiar es la unidad de medida: mientras el equipo hable de precio por token, seguirá presupuestando mal. Si además quieres saber si el sistema funciona lo suficientemente bien como para justificar ese gasto, el método está en cómo evaluar si tu IA funciona.