El trabajo más caro de una oficina contable
Una persona digitando facturas procesa entre 15 y 30 por hora, con una tasa de error que en jornadas largas ronda el 1-3%. Multiplícalo por 800 comprobantes al mes y tienes un costo fijo considerable, un cuello de botella al cierre de cada periodo y una fuente constante de correcciones.
Es, además, un trabajo que nadie quiere hacer y en el que la experiencia no mejora demasiado el resultado.
Tres enfoques distintos, y cuándo usar cada uno
| Enfoque | Cómo funciona | Cuándo conviene |
|---|---|---|
| XML de SUNAT | Lees directamente el comprobante electrónico | Siempre que exista. Es exacto, no hay que interpretar nada |
| OCR con plantillas | Defines dónde está cada dato en el formato | Pocos proveedores con formatos estables |
| Modelo de lenguaje | El modelo lee el documento y devuelve datos estructurados | Muchos formatos distintos o impredecibles |
La primera línea es la que más se olvida y la más importante: si el comprobante es electrónico, no lo proceses como imagen. El XML ya trae el RUC, la serie, el correlativo, la fecha, el detalle y los importes con precisión absoluta. Ningún modelo va a superar eso. Reserva la IA para lo que llega en papel, en foto de WhatsApp o en un PDF sin estructura.
OCR frente a modelo de lenguaje
Son cosas distintas y suelen combinarse. El OCR convierte píxeles en caracteres, como explicamos en esta guía sobre OCR, pero no entiende qué significa lo que leyó: no sabe cuál de los siete números de la página es el total.
Un modelo de lenguaje sí puede interpretar. Le das el texto —o directamente la imagen, si el modelo es multimodal— y le pides un JSON con los campos que necesitas. Maneja bien que cada proveedor tenga un diseño distinto, algo que a las plantillas rígidas las rompe.
La contrapartida: un modelo puede equivocarse con seguridad absoluta. Nunca devuelve "no estoy seguro" salvo que se lo pidas explícitamente. Por eso la validación no es opcional.
Validar: la parte que hace viable el proyecto
Un dato extraído no vale nada hasta que pasa las comprobaciones. Estas son las que aplicamos siempre en el contexto peruano:
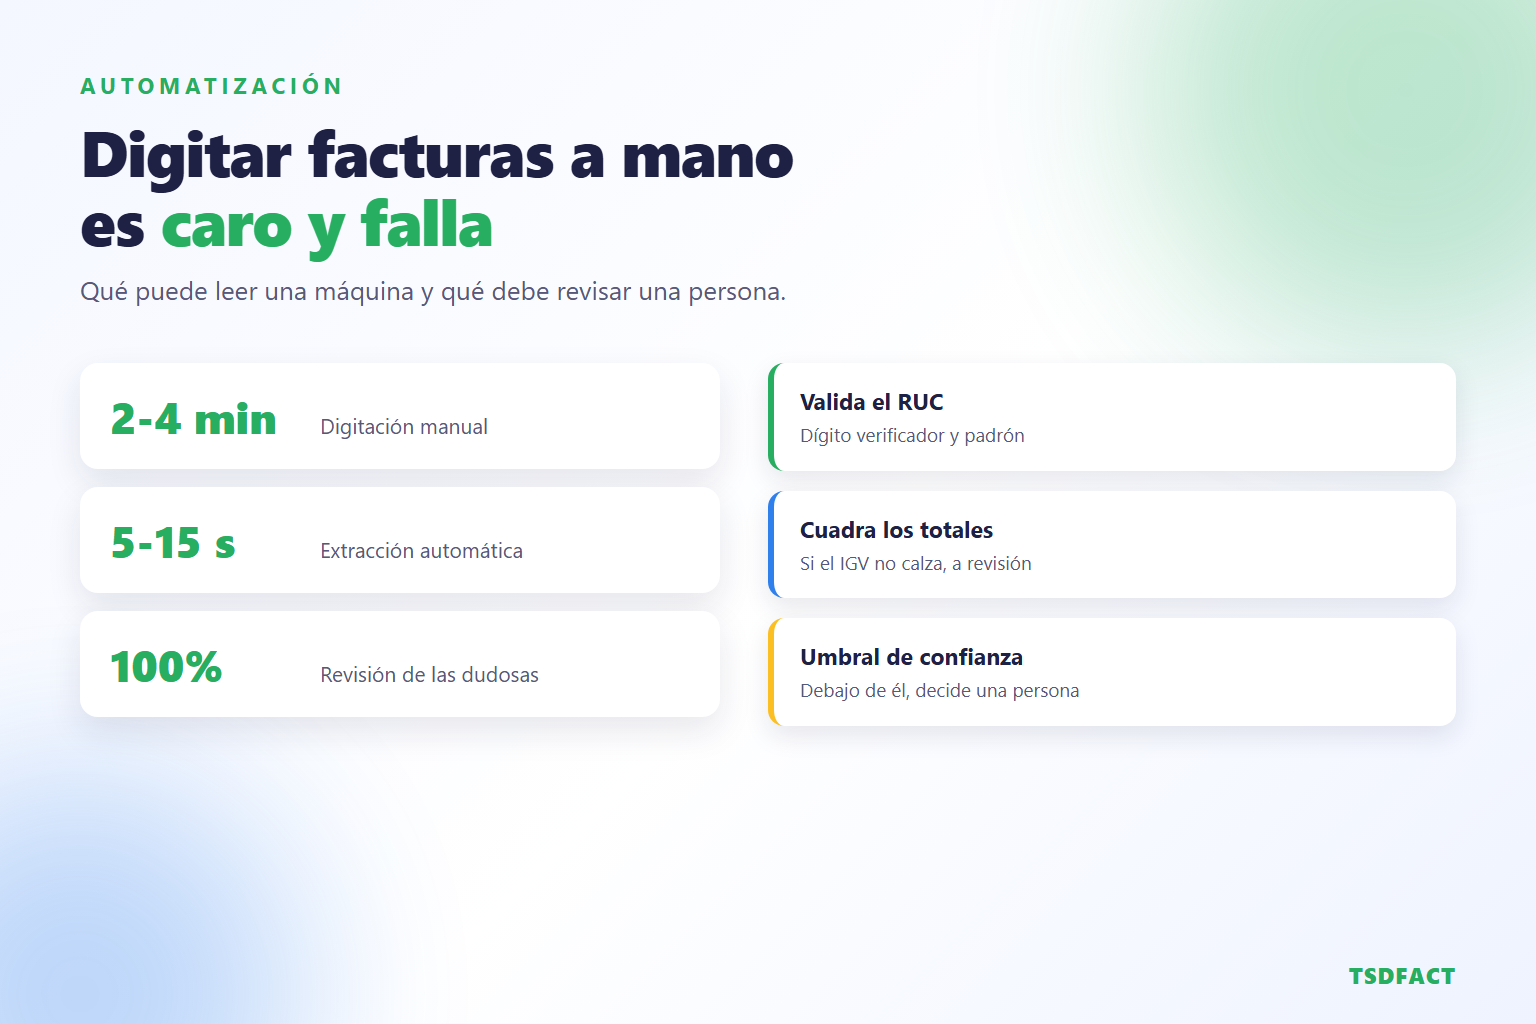
- RUC: 11 dígitos, prefijo válido (10, 15, 17, 20) y dígito verificador correcto. Idealmente, contraste contra el padrón.
- Serie y correlativo: formato esperado según el tipo de comprobante.
- Aritmética: la suma de las líneas debe dar la base imponible; base × 18% debe dar el IGV; base + IGV debe dar el total. Si algo no cuadra por más de un céntimo, el documento va a revisión.
- Fecha: coherente con el periodo y no futura.
- Duplicados: misma serie y correlativo del mismo emisor ya registrados.
Estas reglas atrapan la enorme mayoría de errores de lectura, porque un dígito mal leído casi siempre rompe alguna de ellas.
El umbral de confianza y el humano en el circuito
El diseño que funciona no es "la IA lo hace todo" ni "una persona revisa todo". Es un umbral:
Documento
   |
   +-- ¿Hay XML electrónico? --> SÍ --> leer XML, registrar. Fin.
   |                              |
   |                             NO
   |                              v
   +-- Extraer con OCR + modelo
   |
   +-- Validar RUC, aritmética, duplicados
   |
   +-- ¿Todas las validaciones pasan?
         |
         +-- SÍ --> registrar automáticamente
         |
         +-- NO --> cola de revisión humana
                    (solo los campos dudosos, resaltados
                     sobre la imagen del documento)
La cola de revisión es lo que decide si el proyecto se adopta o se abandona. Si obliga a re-digitar todo, nadie la usa. Si muestra el documento con los campos dudosos marcados y permite corregir con dos clics, el equipo la acepta rápido.
Qué precisión exigir
| Campo | Exigencia | Motivo |
|---|---|---|
| RUC del emisor | 100% validado | Un error aquí contamina toda la contabilidad |
| Importe total | 100% validado | Verificable por aritmética; no hay excusa |
| Fecha de emisión | Alta | Determina el periodo tributario |
| Serie y número | Alta | Clave para detectar duplicados |
| Descripción de las líneas | Media | Un error tipográfico no rompe nada |
Fija el objetivo por campo, no un porcentaje global. "95% de precisión" no significa nada si el 5% que falla son los importes.
Los números que hemos visto
En implementaciones de este tipo para empresas medianas peruanas, el patrón se repite:
- Digitación manual: 2 a 4 minutos por comprobante.
- Extracción automática: 5 a 15 segundos, más el tiempo de revisión de las dudosas.
- Proporción que pasa sin intervención: entre 70% y 90%, según la calidad de los documentos.
- El equipo no desaparece: pasa de digitar a revisar excepciones y conciliar, que es donde aporta criterio.
El retorno rara vez viene del ahorro de personal. Viene de cerrar el mes a tiempo, de dejar de pagar facturas duplicadas y de detectar inconsistencias que antes pasaban de largo.
Errores de implementación que hemos visto
Empezar por el caso más difícil. Arranca con los tres proveedores que más volumen aportan y formatos más limpios; amplía después.
No medir la línea base. Si no sabes cuánto tardas hoy ni cuántos errores cometes, no vas a poder demostrar la mejora.
Prometer 100% de automatización. Nunca ocurre. Prometer 80% y cumplirlo genera mucha más confianza.
Enviar documentos con datos de terceros a servicios de los que no sabes nada. Una factura contiene RUC, razón social e importes de tus proveedores y clientes; aplica lo que explicamos en qué pasa con los archivos que subes a herramientas online.
Conclusión
Automatizar la lectura de comprobantes es de los usos de IA con retorno más claro y medible que existen para una empresa peruana, precisamente porque el resultado es verificable: los números cuadran o no cuadran. La clave no está en el modelo que elijas, sino en tres decisiones de diseño — leer el XML siempre que exista, validar todo con reglas duras, y darle a la persona una cola de revisión que sea cómoda de usar.