Por qué no puedes buscar en tu escaneo
Abres el PDF, pulsas Ctrl+F, escribes una palabra que estás viendo en pantalla y el buscador te dice que no hay resultados. No es un fallo del programa: es que ahí no hay texto. Un escaneo es una fotografía, y para la computadora una fotografía de la palabra "contrato" es un conjunto de píxeles oscuros sobre fondo claro, no una palabra.
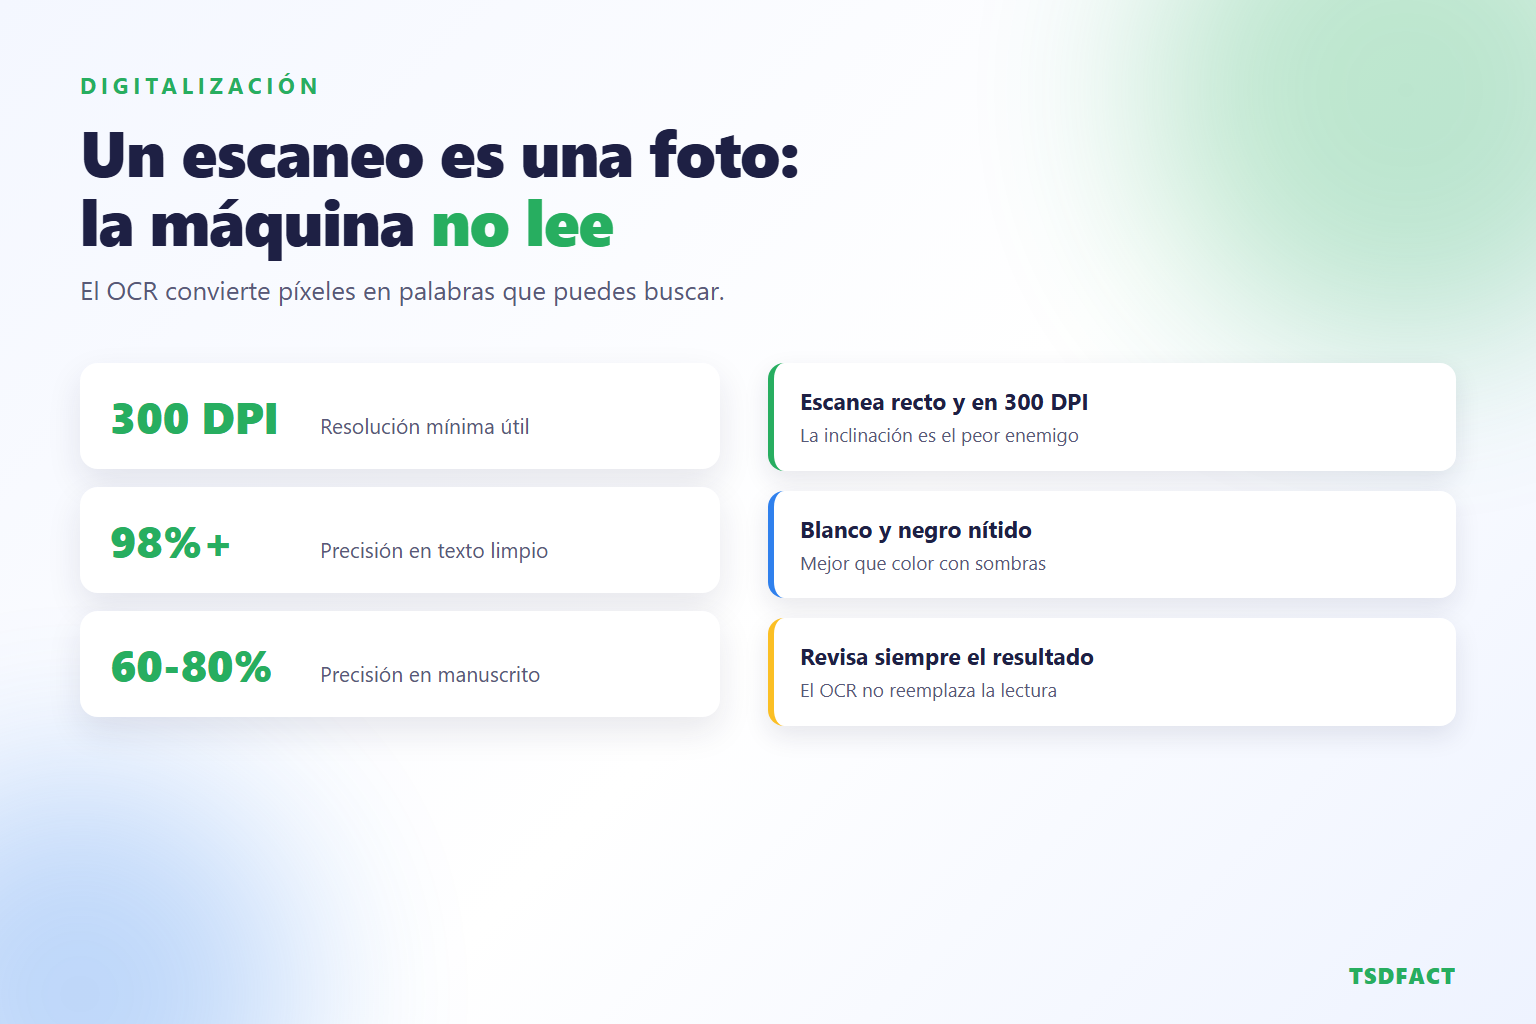
El OCR (reconocimiento óptico de caracteres) es el proceso que mira esos píxeles, identifica las letras y produce texto real. El resultado habitual es un "PDF con capa de texto": la imagen escaneada sigue viéndose igual, pero por debajo hay una capa invisible de texto que sí se puede buscar, copiar y seleccionar.
Qué precisión esperar
Conviene calibrar expectativas antes de procesar 2,000 páginas:
| Tipo de documento | Precisión típica | Comentario |
|---|---|---|
| Impresión limpia, 300 DPI, recta | 98-99% | El escenario ideal; casi no requiere revisión |
| Fotocopia de fotocopia | 85-95% | Confunde caracteres parecidos |
| Documento inclinado o con sombras | 70-90% | Enderezarlo antes mejora muchísimo |
| Foto tomada con el celular | 60-90% | Depende enteramente de la luz y el encuadre |
| Escritura a mano | 60-80% | Muy variable; no confíes sin revisar |
| Tablas complejas | Texto sí, estructura no | Suele perder la disposición en columnas |
Incluso con 98% de acierto, en una página de 500 palabras eso son unos 10 caracteres equivocados. Para buscar es más que suficiente; para reproducir un texto legal palabra por palabra, no.
Los errores clásicos del OCR en español
Hay confusiones que se repiten siempre y conviene conocerlas para buscarlas después:
- rn leído como m — "carne" se vuelve "came".
- l (ele), I (i mayúscula) y 1 (uno) intercambiados entre sí.
- 0 (cero) y O (o mayúscula), especialmente grave en números de RUC y documentos.
- Tildes y la ñ perdidas si el motor no está configurado en español.
- cl leído como d.
Por eso, si el OCR alimenta un proceso automático, nunca uses el resultado en bruto: valida contra reglas. Un RUC tiene 11 dígitos y dígito verificador; un total debe cuadrar con la suma de las líneas. Lo desarrollamos en extraer datos de facturas y documentos con IA.
Cómo preparar el documento para obtener el mejor resultado
- Escanea a 300 DPI. Por debajo el motor pierde detalle; por encima solo ganas peso, no precisión.
- Blanco y negro o escala de grises para documentos de texto. El color añade ruido y peso sin aportar nada.
- Endereza la hoja. Una inclinación de tres grados ya degrada el resultado de forma notoria.
- Luz uniforme si fotografías. Las sombras y el brillo del flash son peores que la baja resolución.
- Aplica el OCR antes de comprimir. Comprimir primero destruye justamente el detalle que el motor necesita.
- Declara el idioma. Un motor configurado en inglés se comerá todas las tildes.
Un caso concreto
Un estudio contable con 14 años de comprobantes en papel: unas 30,000 páginas en archivadores. Encontrar un documento específico tomaba entre 20 minutos y media jornada, según el año.
El proyecto fue escanear a 300 DPI en escala de grises, aplicar OCR en español y guardar los PDF con capa de texto en una carpeta con búsqueda de contenido activada. Resultado: la búsqueda pasó a segundos. No hubo modelos de IA ni base de datos documental — solo el escaneo correcto, el OCR bien configurado y una convención de nombres.
Los dos aprendizajes que dejó: revisar una muestra del 5% antes de procesar todo el lote (un ajuste equivocado multiplicado por 30,000 páginas es muy caro de rehacer), y conservar siempre el escaneo original sin comprimir.
Lo que el OCR no hace
Vale la pena decirlo claro para evitar decepciones:
- No entiende el documento. Reconoce letras; no sabe cuál es el total ni quién firma.
- No arregla un mal escaneo. Si el original está borroso, el resultado será borroso.
- No conserva el diseño complejo. Tablas y columnas suelen salir desordenadas.
- No reemplaza la lectura humana en documentos con valor legal.
Conclusión
El OCR convierte un archivo muerto en un archivo consultable, y eso cambia por completo cómo se trabaja con un fondo documental. Pero es una tecnología con margen de error conocido: sirve espléndidamente para encontrar, y solo con validación adicional para decidir.
Si quieres probarlo con un documento propio, la herramienta de OCR de ChasquiPDF genera el PDF con capa de texto y además permite extraer ese texto a un archivo .txt aparte.