«Me respondió cualquier cosa»
Un cliente escribe el jueves quejándose de que el asistente le dio una información equivocada el lunes. La pregunta inmediata es simple: ¿qué le respondió exactamente, y por qué?
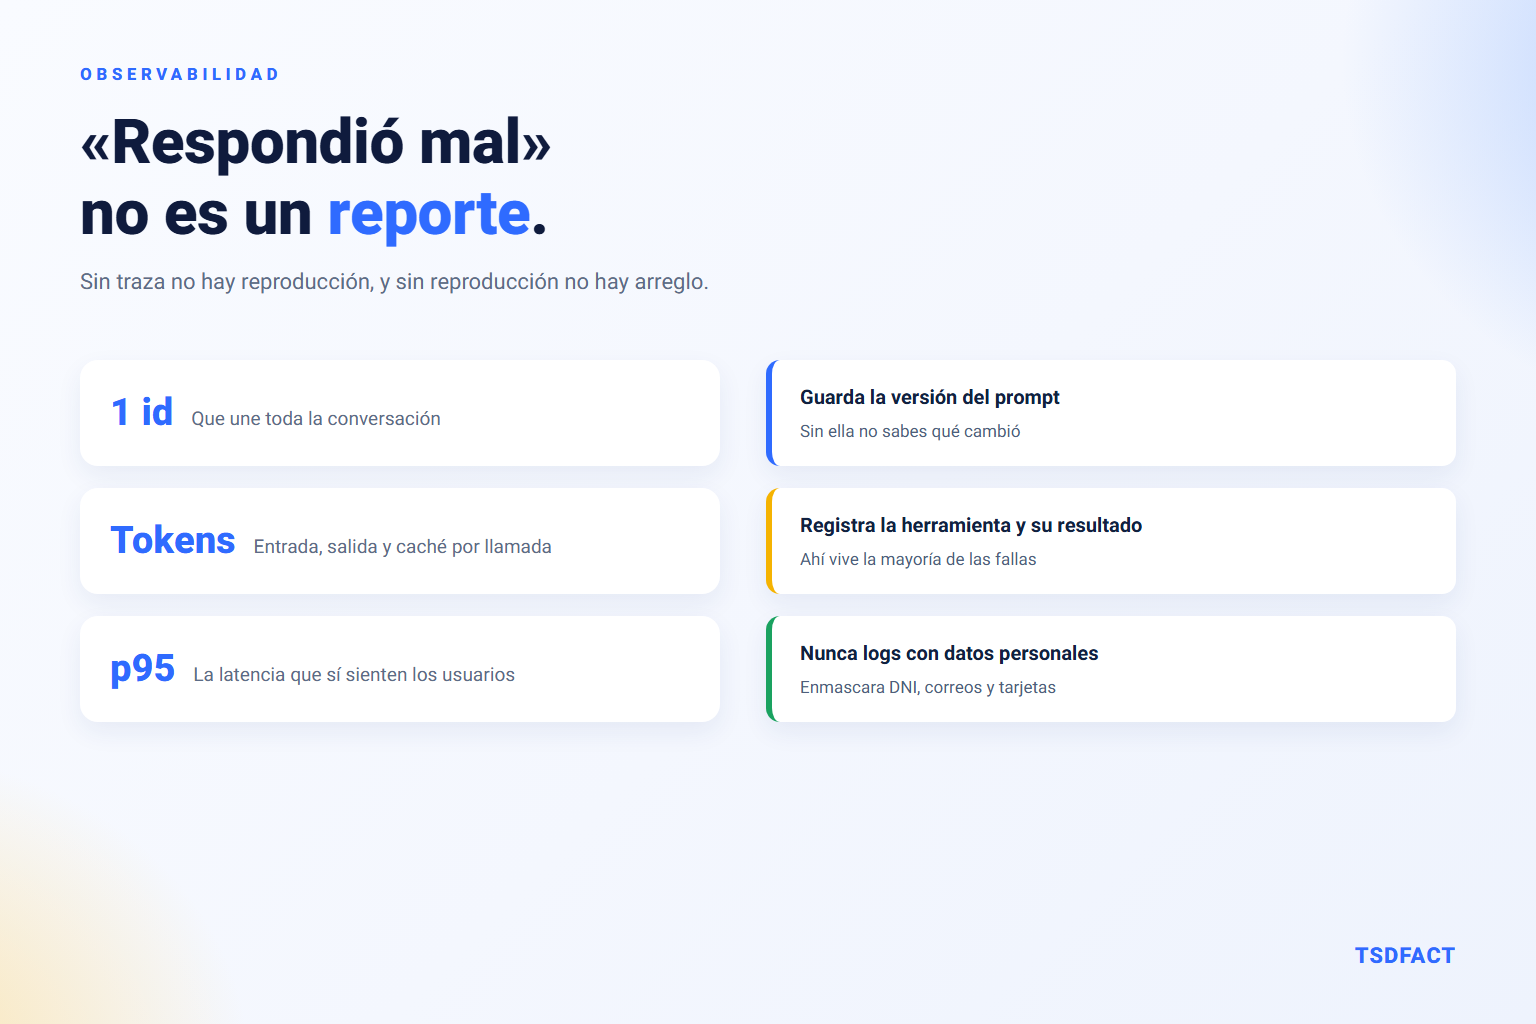
Si la respuesta del equipo es «no tenemos eso guardado», el sistema no tiene un problema de calidad: tiene un problema de observabilidad. Sin traza no hay reproducción, y sin reproducción no hay arreglo, solo conjeturas y cambios de prompt a ciegas.
Por qué los logs de siempre no alcanzan
En software convencional, con la entrada y el código puedes reproducir la salida. Con un modelo generativo, no: la misma entrada puede dar salidas distintas, y la salida depende de cosas que no están en tu código —qué documentos recuperó la búsqueda ese día, qué devolvió la herramienta, qué versión del prompt estaba activa, qué versión del modelo servía el proveedor—.
Por eso la unidad de registro no es la petición HTTP. Es la traza de la tarea completa: todas las llamadas al modelo y a las herramientas que participaron en resolver lo que pidió el usuario, unidas por un mismo identificador.
Qué guardar en cada llamada
| Campo | Para qué sirve |
|---|---|
| trace_id | Une todas las llamadas de una misma tarea |
| Versión del prompt | Sin esto no sabes qué instrucciones estaban activas |
| Modelo y versión | El proveedor actualiza; tu calidad cambia sin que toques nada |
| Tokens: entrada, salida, caché | Costo y diagnóstico de contexto inflado |
| Fuentes recuperadas | Identificadores de los documentos, no el texto entero |
| Herramienta, parámetros y resultado | Donde vive la mayoría de los fallos reales |
| Latencia por paso | Para saber quién es el lento: el modelo o tu ERP |
| Desenlace | Resuelto, escalado, abandonado, error |
Los dos campos que más veces se omiten y más falta hacen son la versión del prompt y el resultado crudo de la herramienta. Cuando un asistente «alucina» un dato, en una proporción alta de los casos el dato equivocado venía de una herramienta que devolvió algo inesperado y el modelo lo redactó con seguridad. Sin el resultado crudo guardado, eso se diagnostica como un fallo del modelo y se intenta arreglar cambiando el prompt, que es exactamente el lugar equivocado.
Qué no debe entrar nunca
Las trazas de IA son especialmente peligrosas porque contienen texto libre escrito por personas, y la gente escribe su DNI, su número de tarjeta y detalles personales en un chat sin pensarlo.
- Enmascara antes de escribir, no después: documentos de identidad, tarjetas, cuentas, correos, teléfonos y direcciones.
- Define retención y cúmplela. Treinta o noventa días suele bastar para depurar; guardar un año «por si acaso» solo agranda el daño de una filtración.
- Separa trazas de logs operativos, con permisos propios. No todo el equipo necesita leer conversaciones de clientes.
- Ojo con el proveedor de observabilidad. Mandar conversaciones completas a un servicio externo es una transferencia de datos personales, con todo lo que eso implica.
Cinco alertas que valen la pena
Más alertas no es mejor monitoreo: es ruido que el equipo acaba silenciando. Estas cinco cubren casi todos los incidentes reales:
- La tasa de errores de herramienta sube. Suele ser el primer síntoma de una integración rota, y aparece antes que las quejas.
- La tasa de aciertos de caché cae en picado. Alguien modificó el inicio del prompt y la factura se va a multiplicar hoy mismo.
- El costo diario supera el umbral. Un bucle de reintentos puede gastar en una tarde el presupuesto del mes.
- La latencia p95 se dispara. El promedio esconde la cola; el p95 es lo que hace que la gente abandone.
- La tasa de escalada se mueve mucho en cualquier dirección. Hacia arriba, algo se rompió; hacia abajo, puede que haya dejado de escalar lo que debía.
Del registro a la mejora
Las trazas valen poco si solo se consultan cuando alguien reclama. El ciclo que convierte observabilidad en calidad es corto:
Semanal: revisar una muestra de conversaciones escaladas y abandonadas. No las resueltas —esas ya salieron bien—. Ahí aparecen los casos que nadie había anticipado.
Al reclamo: abrir la traza, ver qué vio el modelo y determinar si el problema fue la fuente, la herramienta o el razonamiento. Son tres arreglos distintos y se confunden con facilidad.
Continuo: cada fallo real que se diagnostica se convierte en un caso del conjunto de evaluación. Así el sistema no vuelve a romperse por lo mismo, que es la definición práctica de mejorar.
Cuánto cuesta montarlo
Menos de lo que se teme. Para la mayoría de los sistemas basta con una tabla y disciplina: un registro por llamada, con los campos de la tabla de arriba, un identificador de traza que se propaga y un tablero sencillo encima. Las plataformas especializadas ayudan cuando el volumen crece, pero empezar sin ellas es perfectamente viable.
Lo que sí es caro es añadirlo después, porque obliga a tocar todas las llamadas al modelo y porque, mientras tanto, los incidentes se resuelven adivinando.
Conclusión
Un sistema con IA sin trazas es un sistema que nadie puede defender: no se puede explicar una respuesta, ni justificar la factura, ni demostrar que un cambio mejoró algo. Instrumentarlo desde el primer día es la decisión de ingeniería más barata y más rentable del proyecto.
El complemento natural es medir la calidad de forma sistemática, que se explica en cómo evaluar si tu IA funciona, y vigilar el gasto con las palancas de el costo real de la IA.